Anthropic은 2026년 9월 28일 Claude Sonnet 5.5를 공개하며 Sonnet 5보다 30% 이상 빠르고, 대부분의 작업에서 비용이 최대 30% 낮다고 발표했습니다. 그런데 가격표를 보면 입력과 출력 토큰 단가는 Sonnet 5와 같습니다.
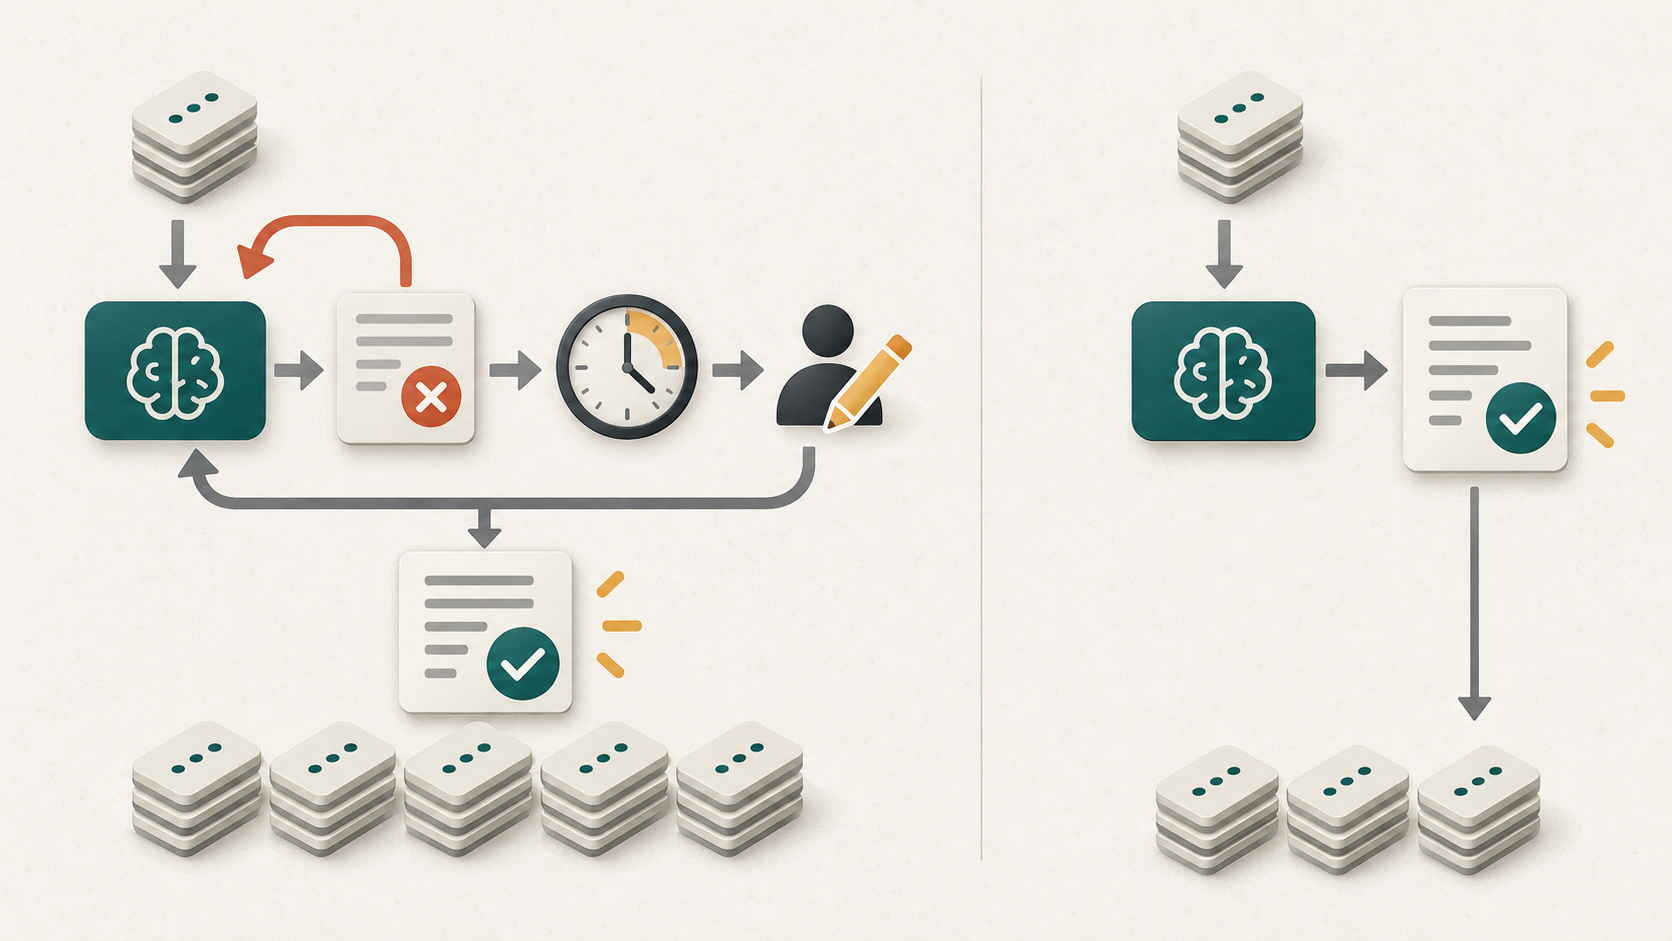
둘은 모순이 아닙니다. 가격표가 말하는 것은 토큰 한 개의 가격이고, Anthropic이 강조한 것은 일 하나를 끝내는 가격입니다. 실제 비용을 보려면 모델 호출 한 번보다 완료된 작업 하나를 단위로 잡아야 합니다.
가격표에서 바뀌지 않은 것
Sonnet 5.5의 API 가격은 100만 토큰 기준으로 다음과 같습니다.
| 항목 | Sonnet 5.5 |
|---|---|
| 입력 토큰 | $2 |
| 출력 토큰 | $10 |
| 캐시 읽기 | $0.20 |
| 캐시 쓰기 | $2.50 |
Anthropic은 이 단가가 Sonnet 5와 같다고 설명합니다. 따라서 입력 10만 토큰, 출력 1만 토큰을 정확히 똑같이 사용한다면 모델 사용료도 같습니다.
차이는 같은 일을 끝낼 때 필요한 토큰과 시간이 같지 않을 수 있다는 데서 생깁니다. Sonnet 5.5가 더 짧은 경로로 문제를 해결하고, 잘못된 시도를 덜 하고, 수정 가능한 결과를 더 빨리 내놓는다면 작업당 총토큰은 줄어듭니다. Anthropic이 “최대 30% 낮은 비용”을 설명하며 든 근거도 작업당 필요한 토큰 감소입니다.
여기서 ‘최대’라는 말을 빼면 안 됩니다. 모든 코드베이스, 모든 문서 작업, 모든 프롬프트에서 30%가 줄어든다는 뜻은 아닙니다. 공식 발표는 출발점이고, 실제 절감률은 각자의 작업으로 확인해야 합니다.
작업당 비용에는 네 항목이 들어갑니다
모델 사용료만 놓고 보면 다음 식으로 시작할 수 있습니다.
모델 사용료 = 입력 토큰 비용 + 출력 토큰 비용 + 캐시 비용
하지만 운영 비용을 알고 싶다면 범위를 넓혀야 합니다.
작업당 총비용 = 모델 사용료 + 재시도 비용 + 사람 수정 시간 + 기다리는 시간
예를 들어 첫 답이 싸더라도 테스트를 통과하지 못해 세 번 다시 돌리면 총비용이 올라갑니다. 반대로 출력 토큰이 조금 많아도 처음부터 검토 가능한 결과가 나오면 사람의 수정 시간이 줄 수 있습니다. 코딩 에이전트라면 테스트 실패 횟수와 PR 완성 시간, 문서 작업이라면 사실 오류와 수정 시간을 함께 봐야 합니다.
이 구분은 모델 비교를 꽤 다르게 만듭니다. “100만 토큰당 얼마인가”는 계산하기 쉽지만, “업무 하나를 승인 가능한 상태로 만드는 데 얼마가 드는가”가 실제 선택에 더 가깝습니다.
같은 단가에서도 계산이 달라지는 예시
아래는 실제 Sonnet 5와 5.5를 측정한 결과가 아니라 계산 방법을 보여 주기 위한 가상 예시입니다. 두 모델의 단가가 모두 입력 100만 토큰당 2달러, 출력 10달러라고 두겠습니다.
모델 A가 첫 시도에 입력 8만 토큰과 출력 8천 토큰을 쓰고, 테스트 실패로 같은 규모의 작업을 한 번 더 했다면 모델 사용료는 약 0.48달러입니다. 한 번 실행할 때 입력 0.16달러와 출력 0.08달러, 두 번 합계입니다.
모델 B가 같은 일을 입력 6만 토큰과 출력 6천 토큰 한 번으로 끝냈다면 약 0.18달러입니다. 토큰 한 개의 가격은 같지만, 작업 경로와 재시도가 달라 총액이 달라졌습니다.
여기에 사람이 결과를 고치는 시간이 A는 20분, B는 5분이었다면 차이는 API 청구액보다 커질 수 있습니다. 반대로 B의 첫 결과가 짧지만 중요한 오류를 놓쳐 검토 시간이 더 길어졌다면 싼 모델이라고 할 수 없습니다. 그래서 토큰 로그와 함께 테스트 결과와 수정 시간을 같은 행에 남겨야 합니다.
캐시가 섞인 비교라면 계산도 다시 나눕니다. 반복된 입력 중 어느 부분이 캐시 읽기로 처리됐는지 기록하지 않으면 모델 개선과 캐시 적중 효과를 구분하기 어렵습니다.
effort가 같지 않으면 비교도 어긋납니다
Sonnet 5.5는 effort 설정으로 속도와 추론량을 조절합니다. Anthropic 발표 기준으로 Claude 앱과 Claude Code의 기본 effort는 Medium이고, Claude Platform의 기본값은 High입니다. 낮은 설정은 더 빠르고 적은 토큰을 쓰며, 높은 설정은 더 오래 생각하고 결과를 더 꼼꼼히 확인합니다.
따라서 앱에서 느낀 속도와 API 기본값의 비용을 그대로 비교하면 조건이 다를 수 있습니다. 모델 A는 Medium, 모델 B는 High로 두고 “B가 더 비싸다”고 결론 내리면 effort 차이를 모델 차이로 잘못 읽을 수 있습니다.
비교할 때는 다음을 고정하는 편이 좋습니다.
- 같은 작업 설명과 입력 자료
- 같은 effort 또는 품질 목표
- 같은 도구와 권한
- 같은 완료 조건과 테스트
- 같은 횟수의 반복 실행
한 번의 성공 사례보다 여러 작업의 중앙값을 보면 우연한 긴 출력이나 재시도의 영향을 줄일 수 있습니다.
캐시는 ‘긴 입력을 반복하는 일’에서 따로 봅니다
캐시 읽기 가격은 입력 토큰보다 낮습니다. 긴 시스템 지시, 큰 코드베이스 설명, 반복해서 참조하는 문서를 캐시로 재사용할 수 있다면 같은 입력을 매번 새로 처리하는 것보다 비용을 줄일 수 있습니다.
반대로 요청마다 자료가 완전히 바뀌면 캐시 이점은 작습니다. 모델을 비교할 때 캐시 적중률까지 다르면 토큰 단가만으로 원인을 설명하기 어렵습니다. 최소한 새 입력, 캐시 쓰기, 캐시 읽기를 나눠 기록해야 합니다.
Sonnet과 Opus의 선택도 ‘작업 경계’로 봐야 합니다
Anthropic은 Sonnet 5.5를 범위가 분명한 일상 작업, 버그 수정, 문서·슬라이드·스프레드시트 제작에 강한 모델로 소개합니다. Opus 5.5는 더 복잡하고 세심한 판단이 필요한 작업에 둡니다.
이 구분은 “Sonnet은 쉬운 일, Opus는 어려운 일”이라는 고정 규칙보다 라우팅의 출발점에 가깝습니다. 업무를 작고 검증 가능한 단위로 나눌 수 있다면 Sonnet으로 처리하고, 요구사항이 모호하거나 잘못된 판단의 비용이 큰 부분만 더 강한 모델로 넘기는 방식도 가능합니다.
모든 요청을 가장 비싼 모델에 보내는 것보다, 일의 범위와 실패 비용에 맞춰 모델을 고르는 편이 작업당 비용을 설명하기 쉽습니다.
직접 비교할 때 남길 최소 기록
| 기록할 항목 | 이유 |
|---|---|
| 입력·출력·캐시 토큰 | API 사용료 계산 |
| 첫 결과까지 걸린 시간 | 체감 속도 비교 |
| 재시도 횟수 | 실패가 만든 숨은 비용 확인 |
| 테스트 통과 여부 | 완료 품질을 같은 기준으로 맞춤 |
| 사람 수정 시간 | 토큰 밖의 실제 운영 비용 확인 |
| 최종 승인 여부 | ‘작업 완료’의 기준 통일 |
작업 열 개만 이 형식으로 비교해도 토큰 단가표보다 유용한 그림이 나옵니다. 단순 요약에서는 차이가 거의 없고, 도구를 여러 번 쓰는 코딩 작업에서만 재시도가 줄 수도 있습니다. 반대 결과가 나올 수도 있습니다.
핵심 정리
- Sonnet 5.5의 입력·출력 토큰 단가는 Sonnet 5와 같습니다.
- Anthropic이 말한 비용 절감은 같은 일을 끝내는 데 필요한 토큰이 줄 수 있다는 주장입니다.
- effort, 캐시, 재시도, 사람 수정 시간을 맞추지 않으면 모델 비교가 어긋납니다.
- “최대 30%”를 자기 업무의 예상 절감률로 쓰기 전에 동일 작업으로 직접 측정해야 합니다.
- 모델 선택의 단위는 호출 한 번보다 승인 가능한 작업 하나가 더 유용합니다.