문서형 AI를 만들 때 처음 만나는 선택은 대개 이렇습니다. 자료를 전부 긴 컨텍스트에 넣을지, 필요한 부분만 찾아 주는 RAG(Retrieval-Augmented Generation)를 먼저 만들지입니다.
예전에는 컨텍스트 창이 작아 RAG가 사실상 기본값인 경우가 많았습니다. 지금은 긴 문서 여러 개를 한 요청에 넣을 수 있는 모델이 늘었습니다. 그렇다고 RAG가 끝난 것도, 긴 컨텍스트가 항상 더 단순한 것도 아닙니다. 둘은 자료의 크기보다 자료를 어떻게 바꾸고, 가리고, 인용하고, 평가할지에서 차이가 납니다.
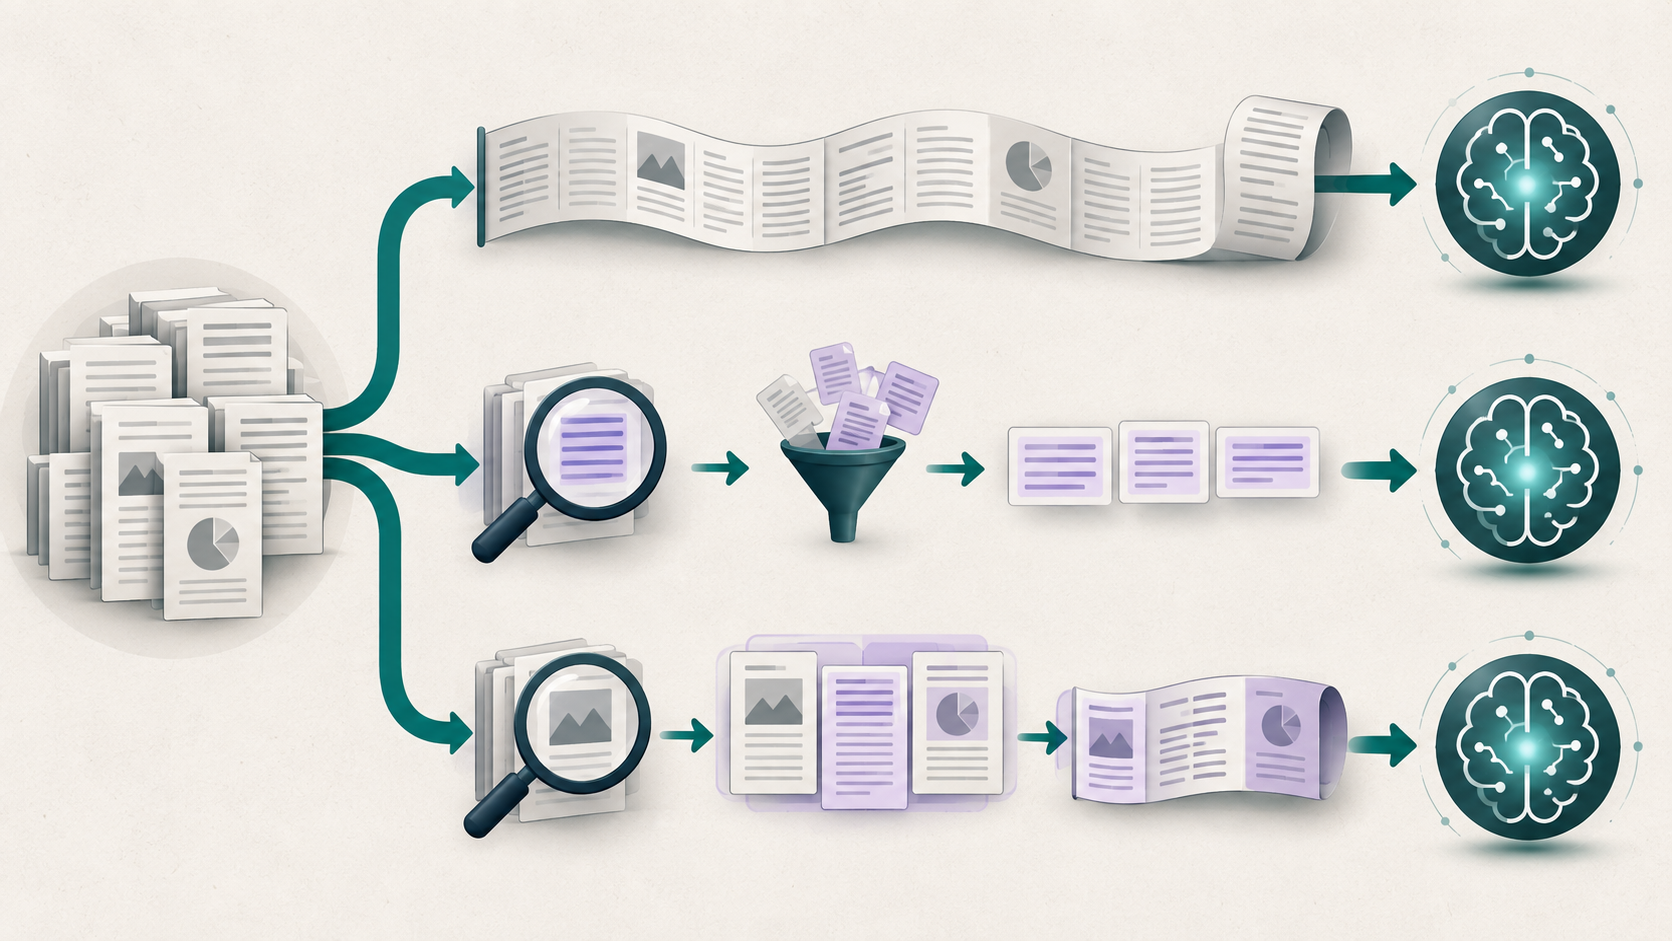
두 방식은 모델에게 자료를 건네는 시점이 다릅니다
긴 컨텍스트 방식은 질문과 관련 있을 수 있는 자료를 모델 입력에 한꺼번에 넣습니다. 구현은 단순합니다. 파일을 읽어 프롬프트에 붙이고 질문하면 됩니다. 문서 사이의 연결을 모델이 직접 찾을 수 있고, 청크 경계에서 문장이 잘리는 문제도 적습니다.
RAG는 먼저 검색합니다. 일반적인 흐름은 다음과 같습니다.
- 문서를 작은 청크로 나눕니다.
- 각 청크를 임베딩해 검색 가능한 저장소에 둡니다.
- 질문과 가까운 청크를 찾습니다.
- 찾은 청크만 프롬프트에 넣어 답을 만듭니다.
AWS는 RAG를 외부의 최신·도메인·사내 지식을 별도 재학습 없이 모델에 연결하는 방식으로 설명합니다. 자료가 크더라도 질문에 필요한 일부만 보내므로 입력을 제한할 수 있습니다.
작은 자료 묶음이라면 긴 컨텍스트가 좋은 출발점입니다
파일 몇 개로 개념 검증을 하는 단계라면 전체 자료를 넣는 방식이 빠릅니다. 수집 파이프라인, 임베딩 모델, 벡터 저장소, 검색기부터 만들지 않아도 됩니다. 검색 실패인지 생성 실패인지 나눠 추적할 필요도 적습니다.
Anthropic은 2024년 Contextual Retrieval 글에서 지식 저장소가 20만 토큰보다 작다면 전체를 프롬프트에 넣는 단순한 방법을 고려할 수 있다고 설명했습니다. 이 수치는 당시 Claude와 프롬프트 캐시를 전제로 한 제안입니다. 모든 모델과 서비스에 그대로 적용하는 법칙은 아닙니다.
더 중요한 기준은 실제 평가입니다. OpenAI도 긴 컨텍스트에서 모델이 매우 긴 입력의 모든 위치에 같은 주의를 주지 못할 수 있으므로, 서로 다른 컨텍스트 크기로 정확도를 확인하라고 안내합니다. “창 안에 들어간다”와 “필요한 정보를 안정적으로 찾는다”는 같은 말이 아닙니다.
긴 컨텍스트로 먼저 시작하기 좋은 조건은 이렇습니다.
- 자료가 작고 한 번에 넣을 수 있습니다.
- 문서가 자주 바뀌지 않습니다.
- 모든 사용자가 같은 자료를 볼 수 있습니다.
- 질문마다 전체 문맥을 함께 봐야 합니다.
- 빠르게 기준 정확도를 만들고 싶습니다.
자료가 커지고 자주 바뀌면 RAG의 이유가 생깁니다
문서가 수만 개로 늘어나면 매번 전체를 보낼 수 없습니다. 최신 정책만 반영하거나, 부서별로 볼 수 있는 자료를 나누거나, 답의 근거 문단을 정확히 보여 줘야 할 때도 검색 계층이 필요합니다.
RAG가 유리해지는 조건은 다음과 같습니다.
- 전체 자료가 컨텍스트 한도를 넘습니다.
- 문서가 계속 추가·수정·삭제됩니다.
- 사용자와 부서마다 접근 권한이 다릅니다.
- 특정 문단과 문서 단위의 출처가 필요합니다.
- 질문에 따라 적은 자료만 읽어 지연과 비용을 줄여야 합니다.
대신 RAG에는 운영 부품이 생깁니다. AWS의 운영 지침에는 자료 연결, 전처리, 임베딩, 벡터 저장소, 검색기, 가드레일, 오케스트레이션, 권한 관리가 포함됩니다. 단순한 데모와 실제 서비스 사이의 차이가 여기서 커집니다.
RAG의 약점은 ‘찾지 못한 정보는 답에 들어갈 수 없다’는 점입니다
RAG에서는 검색 품질이 상한선을 만듭니다. 정답이 있는 청크를 가져오지 못하면 뒤의 모델이 아무리 좋아도 근거 있는 답을 만들기 어렵습니다.
청킹도 문제를 만듭니다. “회사는 전분기보다 3% 성장했다”라는 문장만 떼어 놓으면 어느 회사, 어느 분기인지 사라질 수 있습니다. Anthropic은 이런 문맥 손실을 줄이기 위해 각 청크 앞에 문서 전체 안에서의 짧은 설명을 붙이는 Contextual Retrieval을 제안했습니다.
정확한 제품 코드나 오류 번호처럼 단어가 중요한 질문은 의미 기반 임베딩만으로 놓칠 수 있습니다. 이때 키워드 검색을 함께 쓰거나 결과를 재정렬하는 단계가 필요할 수 있습니다. RAG는 벡터 데이터베이스 하나를 붙이면 끝나는 기능이 아닙니다.
긴 컨텍스트의 약점은 단순함이 입력 비용으로 돌아올 수 있다는 점입니다
전체 자료를 넣으면 검색 시스템은 줄지만 모델이 읽어야 할 토큰은 늘어납니다. 문서가 길어질수록 지연 시간과 비용이 커질 수 있고, 관련 없는 자료가 주의를 분산시킬 수 있습니다.
프롬프트 캐시가 반복 입력의 비용을 낮출 수 있지만 자료가 자주 바뀌거나 사용자마다 다른 문서를 붙이면 캐시 이점이 줄 수 있습니다. 또한 모델이 긴 입력 안에서 근거를 찾았는지, 비슷한 문장을 잘못 골랐는지 평가해야 합니다.
긴 컨텍스트도 검색이 없는 구조라기보다 모델 내부의 검색 능력에 더 많이 의존하는 구조로 볼 수 있습니다.
실제 선택은 세 가지입니다
| 시작 구조 | 잘 맞는 상황 | 먼저 확인할 위험 |
|---|---|---|
| 전체 자료를 긴 컨텍스트에 넣기 | 작은 고정 자료, 빠른 실험 | 입력 비용, 긴 문맥 정확도 |
| RAG로 관련 청크만 넣기 | 큰 자료, 잦은 갱신, 권한 분리 | 검색 누락, 청크 문맥 손실 |
| RAG로 찾고 긴 원문을 넣기 | 정확한 검색과 넓은 문맥이 모두 필요 | 구조 복잡도, 지연, 중복 토큰 |
세 번째 혼합 방식은 검색 결과를 최종 답의 작은 청크로만 쓰지 않고, 관련 문서나 주변 절을 다시 불러 모델에 더 넓게 주는 방법입니다. 검색은 범위를 줄이고 긴 컨텍스트는 문맥을 회복합니다. 대신 구성요소가 늘기 때문에 평가와 관찰 장치가 더 필요합니다.
모델보다 먼저 평가셋을 만듭니다
아키텍처를 정하기 전에 실제 질문 30~50개를 모으는 편이 좋습니다. 각 질문에 정답뿐 아니라 근거 문서와 위치, 허용되지 않은 자료, 최신성 기준을 붙입니다.
그다음 세 구조를 같은 질문으로 비교합니다.
- 정답 정확도
- 올바른 근거를 찾은 비율
- 근거가 없을 때 모른다고 한 비율
- 답 하나당 입력·출력 토큰과 비용
- 첫 답까지 걸린 시간
- 문서 변경이 반영되는 시간
- 권한 밖 자료가 섞이지 않는지
정확도만 보면 전체 입력이 이길 수 있고, 비용만 보면 RAG가 이길 수 있습니다. 권한과 최신성까지 넣으면 결과가 다시 바뀔 수 있습니다. 그래서 “RAG냐 긴 컨텍스트냐”보다 “우리 실패 비용은 무엇이냐”가 먼저입니다.
핵심 정리
- 작은 고정 자료로 시작할 때는 긴 컨텍스트가 가장 빠른 기준선이 될 수 있습니다.
- 자료가 크고 자주 바뀌거나 권한이 나뉘면 RAG의 검색 계층이 필요해집니다.
- 긴 컨텍스트는 모든 정보를 넣을 수 있어도 모든 정보를 안정적으로 찾는지 평가해야 합니다.
- RAG는 검색 누락과 청크 문맥 손실을 별도로 관리해야 합니다.
- 둘 중 하나를 고르는 대신 검색으로 범위를 줄이고 관련 원문을 길게 넣는 혼합 구조도 가능합니다.