지금 익숙한 Codex가 불과 2~3개월 뒤에는 원시적으로 보일 수 있다는 말이 나왔습니다. 차세대 모델 출시 예고처럼 들리지만, 약 44분짜리 인터뷰를 끝까지 이어서 보면 변화의 범위는 모델 하나보다 넓습니다.
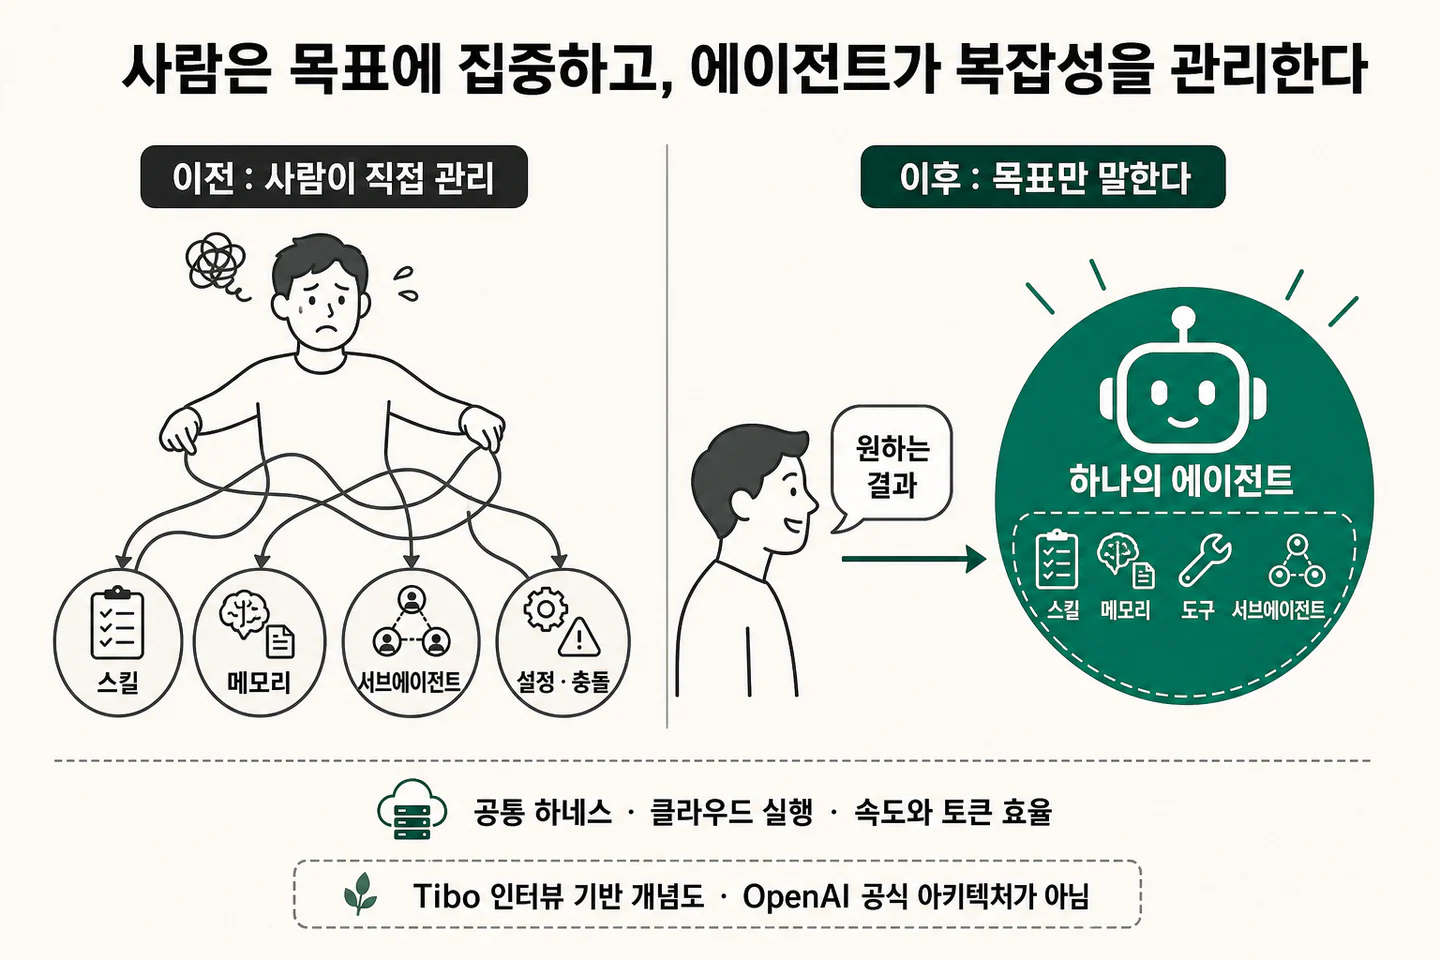
반복 작업을 맡기는 스킬(skill), 기억을 보완하는 메모리(memory), 여러 작업을 나누는 서브에이전트(subagent). 지금은 사람이 이 장치들을 직접 연결합니다. 인터뷰가 그리는 다음 단계에서는 에이전트(agent)가 이 복잡성을 흡수합니다. ChatGPT와 Codex의 통합, 클라우드 실행, Ultra Fast, 토큰 효율(token efficiency)도 이 목표를 받치는 요소입니다.
이 발언을 남긴 사람은 Tibo Sottiaux입니다. 그가 말하는 변화의 첫 답은 이렇습니다.
사람이 AI를 관리하는 방법을 계속 배우는 대신, 하나의 에이전트가 사람과 작업 환경을 이해하도록 제품을 다시 짜려는 것입니다.
이 글은 무엇입니까? 2026년 8월 25일 공개된 Matthew Berman과 Tibo Sottiaux의 인터뷰를 중심으로 OpenAI의 제품 방향을 읽은 글입니다. 발언의 맥락은 OpenAI 공식 Codex 페이지와 Codex App Server 설명, 8월 18일 모델 개발 속도 조절 발표와 대조했습니다. 인터뷰에
Astra & Next Gen Models구간이 있지만 Astra 출시일이나 DevDay 공개 여부를 확인해 주지는 않습니다.
스킬과 서브에이전트를 직접 관리하는 단계는 오래가지 않을 수 있다
코딩 에이전트를 깊게 쓸수록 모델 주변의 설정이 빠르게 늘어납니다. 반복 작업은 스킬로 정리하고, 빠진 기억은 별도로 보완하고, 큰 작업은 서브에이전트로 나눕니다. 여러 에이전트가 같은 파일을 건드리지 않도록 조정하는 일도 사람 몫입니다.
Tibo는 이를 최종 형태로 보지 않습니다. 스킬 파일은 계속 관리해야 하고, 메모리는 모든 것을 기억하지 못하며, 서브에이전트가 늘수록 사용자는 작은 에이전트 조직의 관리자가 됩니다. 하나의 파트너와 일한다는 감각도 그때마다 끊깁니다.
그가 제시한 목표는 사용자의 목표와 일상, 팀의 맥락을 이어서 이해하고 필요할 때 행동하는 하나의 에이전트입니다. 오케스트레이션(orchestration)은 사라지기보다 제품 안으로 들어갑니다.
지금 쓰는 AGENTS.md와 스킬, 메모리가 당장 쓸모없어진다는 이야기는 아닙니다. 현재 모델의 빈틈을 메우는 데 필요한 장치입니다. 다만 사용자가 이 구성요소를 계속 손으로 관리하는 경험은 과도기에 가깝습니다.
같은 에이전트가 사용자에 따라 다른 얼굴을 보여준다
이 목표를 따라가면 ChatGPT와 Codex를 합치려는 이유도 분명해집니다.
Tibo는 인터뷰에서 미래 모델이 둘의 통합을 요구한다고 설명합니다. 아래에서는 같은 하네스(harness)를 쓰고, 여러 형식의 입력을 다루며, 음성을 중심으로 상호작용할 수 있는 하나의 에이전트가 움직입니다. 사용자가 프로그래밍을 하는지에 따라 화면과 도구가 달라집니다.
개발자 화면에는 저장소와 터미널, 코드 리뷰가 크게 보일 수 있습니다. 다른 업무를 하는 사람에게는 이 요소가 거의 보이지 않을 수 있습니다. 인터페이스는 달라도 밑에서 이어지는 에이전트는 같은 쪽으로 수렴합니다.
OpenAI의 공식 Codex 페이지는 이미 Codex를 “ChatGPT 안의 같은 코딩 에이전트”로 소개합니다. ChatGPT와 편집기, 터미널에서 같은 에이전트를 쓴다는 설명도 함께 나옵니다. 인터뷰의 방향이 아직 제품과 무관한 먼 미래 구상만은 아닌 이유입니다.
코딩 에이전트라는 구분도 점차 능력과 인터페이스를 가리키는 말로 바뀔 수 있습니다. 코딩 전용 지능이 따로 존재하기보다, 하나의 범용 에이전트가 개발 상황에서 코딩 능력과 개발자용 화면을 강하게 드러내는 형태입니다.
에이전트의 작업량이 노트북 한 대를 넘어선다
그렇다면 왜 Tibo는 다음 세대 모델에 “노트북보다 더 많은 것”이 필요하다고 말했을까요?
인터뷰의 설명은 로컬 GPU 성능보다 작업량에 초점을 둡니다. 노트북은 한 사람이 입력하고 생각하는 속도, 동시에 다루는 애플리케이션 수에 맞춰진 기계입니다. 더 강한 에이전트는 코드를 탐색하면서 테스트를 만들고, 컴파일하고, 다른 가설을 검증하며, 여러 애플리케이션을 병렬로 다룰 수 있습니다.
모델이 빨라질수록 병목은 CPU와 네트워크, 도구 실행, 작업 환경으로 이동합니다. 실행 환경이 클라우드와 지속 실행 쪽으로 넓어지는 이유입니다.
Codex App Server는 이 방향을 실제 구조로 보여줍니다. OpenAI는 같은 Codex 하네스를 여러 제품에서 재사용하고, 서버에 상태를 유지하는 방식을 설명합니다. 원격 머신에서 에이전트를 실행하면 노트북이 잠들거나 연결이 끊겨도 작업을 이어갈 수 있습니다.
이때 클라우드는 모델 API를 호출하는 장소에 그치지 않습니다. 한 사람의 PC가 감당하기 어려운 병렬 작업과 지속 실행을 맡는 작업 공간이 됩니다.
Ultra Fast와 토큰 효율이 작업 리듬을 바꾼다
지금 에이전트가 느리면 여러 개를 동시에 실행하는 편이 낫습니다. Matthew Berman도 한 번에 10~15개 에이전트를 시작한 뒤 결과를 기다리는 작업 방식을 이야기합니다. 처리량은 늘지만 사람은 작업을 계속 나누고, 여러 세션의 상태를 기억하고, 결과가 돌아올 때마다 문맥을 바꿔야 합니다.
Tibo는 Ultra Fast가 이 작업 리듬을 바꿀 수 있다고 봅니다. 코드나 긴 문맥을 생성하면서 도구 호출 부담이 작은 작업은 약 10배 빨라질 수 있습니다. 외부 도구를 자주 부르는 에이전트 작업에서는 다른 병목 때문에 전체 가속이 약 3~4배 수준일 수 있습니다.
최고 속도보다 중요한 변화는 비동기 작업이 다시 실시간 협업에 가까워진다는 점입니다. 사람이 아이디어를 말하고 에이전트가 거의 바로 시제품을 만든 뒤, 같은 맥락에서 수정할 수 있습니다. 여러 에이전트에게 일을 던져 두고 나중에 회수하는 방식과는 흐름이 다릅니다.
Tibo는 1~2년 뒤 지금의 Ultra Fast급 속도가 기본에 매우 가까워질 수 있다고 전망합니다. 더 많은 하드웨어를 쓰는 상위 단계는 남더라도, 지금의 프리미엄 속도 자체는 점차 평범해질 수 있다는 설명입니다.
속도만 빨라져서는 충분하지 않습니다. 에이전트는 한 번 답한 뒤 끝나지 않고, 여러 차례 추론하고 도구를 부르며 결과를 다시 읽습니다. 같은 작업에 필요한 토큰이 줄면 동일한 계산 자원으로 더 많은 일을 처리할 수 있습니다.
Tibo는 Sol이 Terra보다 토큰 효율이 높고, 다음 모델도 Sol보다 크게 개선될 것으로 예상합니다. 여기서 다음 모델의 이름을 Astra라고 특정하지는 않습니다. 인터뷰의 장 제목과 실제 발언 범위를 나눠 읽어야 합니다.
일반 서비스 속도도 바뀌고 있습니다. Tibo에 따르면 Ultra Fast를 제외한 속도 역시 약 3개월 전보다 대략 60% 빨라졌습니다. 그는 이 개선을 모델 교체 하나로 설명하지 않습니다. OpenAI가 기술 스택의 여러 부분을 다시 설계하고, 가장 강한 모델을 그 최적화에 사용한다고 말합니다.
먼저 현실이 된 자기개선은 인프라에서 보인다
이 대목에서 재귀적 자기개선(recursive self-improvement·RSI)이 이어집니다. 흔히 떠올리는 장면은 AI가 다음 세대 AI를 직접 설계하고, 그 AI가 다시 더 강한 AI를 만드는 것입니다. 인터뷰에서 확인되는 현재 단계는 더 구체적입니다.
강한 모델을 CUDA와 서비스·추론 인프라 개선에 사용합니다. 개선된 인프라는 같은 계산 자원에서 더 많은 추론을 가능하게 하고, 확보한 자원은 다시 제품과 연구에 쓰입니다.
더 강한 모델 → 인프라·서비스 최적화 → 비용과 속도 개선 → 같은 컴퓨팅 자원에서 더 많은 AI 작업 → 연구·제품 개발 가속
Tibo는 이 흐름도 넓은 의미의 재귀적 자기개선으로 봅니다. 현재 확인된 범위는 모델이 AI 개발 인프라를 개선하는 실질적인 도구가 됐다는 데까지입니다. 인간 없이 후계 모델을 만드는 단계로 확대하면 인터뷰의 범위를 벗어납니다.
Astra 출시 예고로 좁히면 놓치는 것이 많다
인터뷰가 공개된 시점과 Astra & Next Gen Models라는 장 제목 때문에 9월 DevDay를 떠올리기 쉽습니다. 그러나 Astra 출시일과 DevDay 공개 여부, 다음 모델의 정확한 이름은 인터뷰에서 확정되지 않았습니다. 확인된 발언은 다음 모델의 토큰 효율이 Sol보다 크게 좋아질 것이라는 방향입니다.
OpenAI의 8월 18일 공식 발표도 속도보다 조건을 먼저 보게 합니다. 배포 예정 최신 모델의 강화학습(RL) 훈련은 2주간 중단됐고, 계획된 최대 규모의 프런티어 RL 실행은 계속 보류 중입니다. Astra는 Critical 수준의 사이버 역량에 도달할 가능성 때문에 더 강한 보안과 모니터링 요구를 적용받습니다.
이 인터뷰는 Astra의 DevDay 출시를 뒷받침하는 근거가 아닙니다. 더 분명한 신호는 특정 모델의 일정과 별개로 OpenAI가 다음 세대 모델을 받아들일 제품 구조를 준비하고 있다는 점입니다.
OpenAI가 다시 설계하는 것은 하나의 작업 파트너다
인터뷰의 내용을 묶어 보면 모델, 제품, 인프라가 한 줄로 이어집니다.
강한 모델은 더 복잡한 일을 맡을 수 있습니다. 그 일을 처리하려면 스킬과 메모리, 서브에이전트 관리가 에이전트 안으로 들어가야 합니다. ChatGPT와 Codex는 같은 하네스를 공유하고, 더 많은 도구와 맥락을 다뤄야 합니다. 한 대의 노트북을 넘어서는 실행 환경과 빠른 추론, 높은 토큰 효율도 함께 필요합니다.
모델 → 하네스 → 클라우드 실행 → 사용자 인터페이스를 하나의 제품으로 다시 설계하는 과정입니다.
Tibo는 DeepMind와 OpenAI의 차이를 설명하면서 연구팀과 제품팀이 가깝게 협업하고, 새 능력을 사용자에게 빠르게 내놓은 뒤 피드백으로 제품을 다시 설계하는 문화를 강조했습니다. 모델이 빠르게 변하면 제품 구조도 고정해 둘 수 없다는 관점과 맞닿습니다.
그래서 “Codex가 2~3개월 뒤 원시적으로 보일 것”이라는 말을 벤치마크나 출시일 예고로만 읽으면 중심을 놓치게 됩니다. 지금은 사람이 에이전트를 관리합니다. Tibo가 설명한 다음 단계에서는 에이전트가 사용자와 작업 환경을 이해하고, 필요한 오케스트레이션을 내부에서 처리합니다. 코드와 문서, 다른 업무도 같은 지능으로 이어집니다.
실제 제품이 이 구상을 어디까지 구현할지는 아직 확인해야 합니다. 이번 인터뷰가 분명하게 보여주는 것은 OpenAI가 더 좋은 챗봇 하나보다 지속해서 함께 일하는 하나의 작업 파트너를 만들려 한다는 방향입니다.
참고 자료
- Matthew Berman, Tibo: Ultrafast Mode, The Reset Button, OpenAI vs Anthropic, RSI, and more! — https://www.youtube.com/watch?v=-dPtNf42Qjg
- OpenAI, Codex in ChatGPT — https://openai.com/codex/
- OpenAI, Unlocking the Codex harness: how we built the App Server — https://openai.com/index/unlocking-the-codex-harness/
- OpenAI, Pacing model development in an era of cyber-critical capabilities — https://openai.com/index/pacing-model-development-cyber-capabilities/
- 36Kr/QbitAI, 인터뷰 전체 대화형 정리 — https://www.36kr.com/p/3954557588405634