AI가 AI 학습법까지 고칠 수 있을까 — AI4AI-Bench가 재귀적 자기개선을 재는 법
‘재귀적 자기개선(Recursive Self-Improvement, RSI)’이라고 하면 AI가 자기 자신을 고쳐 더 똑똑해지고, 그다음 버전이 또 자신을 개선하는 장면을 떠올리기 쉽습니다.
AI4AI-Bench는 이 큰 질문을 코딩 에이전트의 알고리즘 설계 문제로 좁힙니다. 질문은 코딩 에이전트에게 AI 학습 코드를 맡겼을 때, 실행 방식을 바꾸는 수준을 넘어 학습 알고리즘 자체를 더 좋게 바꿀 수 있는가입니다.
AI4AI-Bench가 실제로 측정한 것
2026년 8월 공개된 AI4AI-Bench 논문과 공개 저장소를 바탕으로, 이 벤치마크가 ‘AI가 AI를 개선한다’는 말을 어떤 실험 문제로 좁혔는지 정리한 글입니다. 논문이 측정한 대상은 정해진 연구 저장소의 학습 절차를 더 나은 알고리즘으로 수정하는 능력입니다. 에이전트가 자기 가중치를 즉석에서 바꾸는 능력을 시험한 것은 아닙니다.
결과를 높이는 것과 알고리즘을 개선하는 것은 같은 질문이 아닙니다
AI4AI-Bench가 구분하려는 핵심은 실행 수준의 변화와 학습 알고리즘 자체의 변화입니다.
벤치마크는 10개의 고정된 연구 저장소와 10개 학습 알고리즘 계열을 사용합니다. 에이전트는 주어진 연구 코드 안에서 학습 알고리즘을 읽고 수정합니다.
최종 점수와 함께 제출물이 실제로 학습 절차의 알고리즘 계층까지 바꿨는지도 따로 분석합니다. 그래서 ‘점수 상승’과 ‘학습 방법 변경’을 구분할 수 있습니다.
4시간 동안 연구하게 한 뒤, 답안은 새 환경에서 다시 돌립니다
각 과제에서 에이전트는 단일 NVIDIA B300 GPU를 사용해 4시간 동안 저장소를 읽고 실험하며 학습 알고리즘 코드를 수정합니다. 여기까지가 탐색 단계입니다.
그다음에는 에이전트가 만든 소스 패치만 가져갑니다. 제출된 패치는 깨끗한 새 환경에서 처음부터 최대 12시간 다시 실행되고, 에이전트가 볼 수 없는 고정 평가기로 채점됩니다.
흐름을 단순하게 쓰면 이렇습니다.
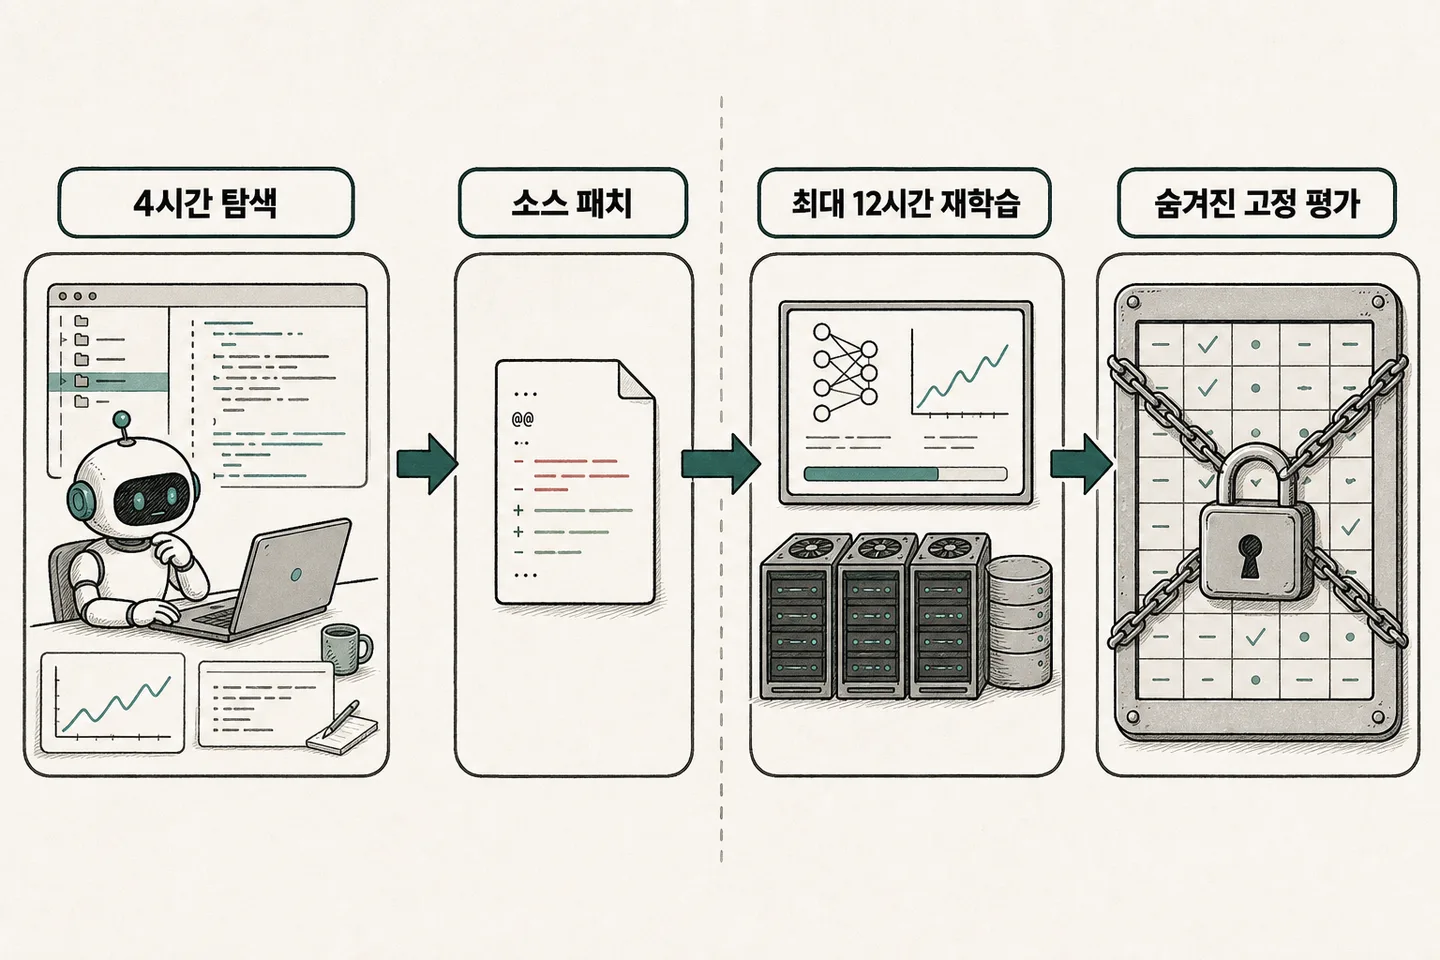
AI4AI-Bench는 탐색 단계에서 만든 소스 패치만 새 환경으로 넘겨 다시 학습하고 평가합니다.
이 구조는 탐색 중에 얻은 일시적인 결과보다 제출한 코드 변화가 새 실행에서도 결과를 만드는지를 봅니다. 공개 GitHub 저장소에도 10개 벤치마크 과제와 탐색·정식 재실행·평가 흐름을 재현하는 도구가 들어 있습니다.
최고 점수 0.250은 ‘25% 성능’이라는 뜻이 아닙니다
논문은 6개 시스템의 29개 설정을 10개 과제에서 평가했습니다. 전체 정규화 점수 평균은 0.166, 최고 시스템은 0.250을 기록했습니다.
이 숫자는 일반적인 정확도 25%처럼 읽으면 안 됩니다. AI4AI-Bench가 정의한 정규화 척도에서 기존 저장소의 알고리즘이 0.1, 각 과제의 최적값이 1.0이 되도록 만든 점수입니다.
0.250은 AI4AI-Bench가 정의한 정규화 점수입니다. 현재 최고 설정도 기존 저장소 알고리즘의 0.1에서 최적점 1.0으로 가는 격차를 크게 남기고 있습니다.
현재 결과는 측정 가능한 개선은 나왔지만, 알고리즘 설계 문제 자체는 여전히 어렵다는 쪽에 가깝습니다. ‘AI가 자기개선을 달성했다’는 증거로 확대할 단계는 아닙니다.
그래도 알고리즘 계층까지 들어간 제출은 달랐습니다
제출물을 알고리즘 계층을 바꾼 그룹과 그렇지 않은 그룹으로 나누자 점수가 갈렸습니다.
논문이 분석한 제출물 가운데 학습 절차의 알고리즘 계층을 수정한 그룹의 평균 점수는 0.226, 그렇지 않은 그룹은 0.126이었습니다.
두 그룹의 평균만으로 알고리즘 변경이 높은 점수의 원인이라고 단정할 수는 없습니다. 확인되는 범위는 학습 방법 자체를 바꾼 시도가 더 높은 평균 점수와 함께 나타났다는 데까지입니다.
AI4AI-Bench는 최종 점수와 함께 에이전트가 학습 방법 자체를 수정했는지도 보여줍니다.
추론 강도를 높이자 ‘무엇을 시도하는가’부터 달라졌습니다
추론 강도(reasoning effort)를 높인 조건에서는 시도 자체가 달라졌습니다.
논문은 알고리즘 계층까지 실제로 손대는 제출의 비율이 8%에서 64%로 증가했다고 보고합니다. 같은 비교에서 평균 점수도 0.094에서 0.196으로 올랐습니다.
점수 상승과 함께 알고리즘 계층을 실제로 바꾼 제출의 비율이 크게 달라졌습니다.
다만 이는 AI4AI-Bench의 10개 과제와 해당 평가 조건에서 관찰된 결과입니다. 모든 AI 연구 문제에서 추론 강도를 높이면 같은 변화가 생긴다고 일반화할 수는 없습니다.
‘AI가 AI를 개선한다’는 말을 조금 더 정확하게 만들었습니다
AI4AI-Bench의 현재 성적만 보면 재귀적 자기개선의 완성이라고 부르기 어렵습니다. 최고 시스템의 정규화 점수는 0.250이고, 벤치마크가 정의한 최적점 1.0과는 거리가 있습니다.
이 벤치마크의 역할은 ‘AI가 AI를 더 좋게 만든다’는 큰 문장을 어떤 코드를 바꿨는지, 새 환경에서 다시 실행되는지, 실제 알고리즘 계층까지 들어갔는지로 쪼개 측정할 수 있게 만드는 데 있습니다.
지금 단계에서 더 정확한 표현은 이렇습니다.
AI 에이전트가 학습 알고리즘 개선 문제에서 성과를 만들 수 있다는 결과는 나왔지만, 현재 시스템이 이 문제를 잘 해결한다고 부르기에는 아직 격차가 큽니다.
재귀적 자기개선을 둘러싼 논의가 계속된다면, 중요한 질문은 단순히 “점수가 올랐나?”에서 끝나지 않습니다. “AI가 정말 학습 방법 자체를 개선했나?”까지 구분해야 합니다. AI4AI-Bench는 그 질문을 측정 가능한 형태로 바꾼 벤치마크입니다.