Stripe는 왜 OpenRouter를 인수하려 할까 — 멀티모델 라우팅이 인프라가 된 이유
AI API를 연결할 때 모델 하나만 고르면 끝날까요? 실제 운영에서는 같은 이름의 모델도 여러 공급자가 제공하고, 요청마다 가격과 속도, 가용성이 달라집니다. 어느 한 곳이 멈추면 다른 곳으로 넘길 방법도 필요합니다.
이 복잡한 중간 구간을 맡는 회사가 OpenRouter입니다. Stripe는 2026년 8월 19일 OpenRouter를 인수하기로 합의했다고 발표했습니다. 아직 거래 완료를 뜻하는 단계는 아닙니다.
뉴스의 핵심은 Stripe가 특정 AI 모델 회사를 고른 것이 아니라, 여러 모델과 공급자 사이에서 요청을 배분하는 멀티모델 라우팅(multimodel routing) 층을 선택했다는 데 있습니다.
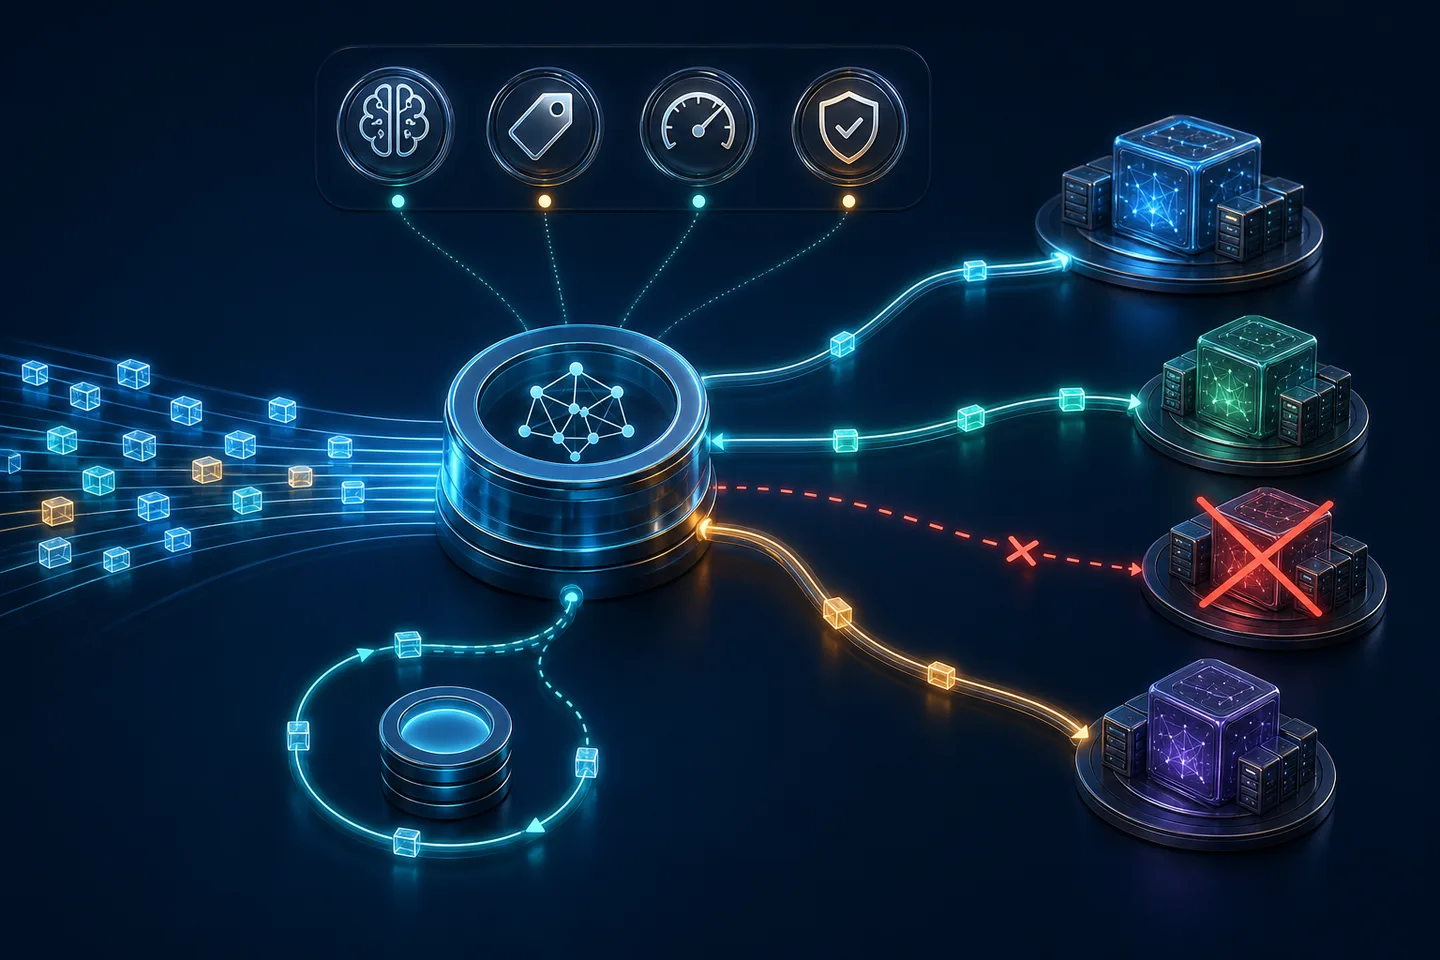
멀티모델 라우터는 요청 조건에 맞는 경로를 고르고, 한 공급자를 쓸 수 없을 때 다른 경로로 넘기는 중간층입니다.
OpenRouter의 규모보다 먼저 봐야 할 역할
OpenRouter는 하나의 인터페이스에서 여러 AI 모델과 공급자를 선택할 수 있게 하는 gateway입니다. 회사 발표 기준으로 400개가 넘는 모델을 제공하고 하루 10조 토큰 이상을 처리하며, 개발자와 기업을 합친 커뮤니티가 1천만 명을 넘습니다. Stripe는 80개가 넘는 provider의 400개 이상 모델을 대상으로 token usage를 route하고 optimize한다고 설명했습니다.
규모가 큰 API 중개 서비스라는 설명만으로는 인수 이유가 잘 보이지 않습니다. 공통 API 형식은 출발점이고, 그 뒤에 모델과 provider를 고르는 운영 기능이 붙습니다.
- 요청에 맞는 모델을 고릅니다.
- 같은 모델을 제공하는 여러 provider 가운데 보낼 곳을 정합니다.
- 가격·속도·가용성을 관찰하고 비용을 관리합니다.
- 첫 provider가 실패하면 다른 provider로 넘깁니다.
- 여러 차례 이어지는 대화에서는 cache를 유지할 수 있도록 같은 provider를 이어 씁니다.
각 항목은 모델이 답을 얼마나 잘 쓰느냐와 다른 운영 문제입니다.
첫 번째 라우팅은 어떤 모델에 맡길지 정합니다
요청마다 필요한 성능과 비용 조건이 다릅니다. 짧은 분류와 긴 분석, 빠른 응답이 중요한 작업과 정확성이 더 중요한 작업을 같은 모델에 보낼 이유는 줄어듭니다.
Stripe는 이 선택을 작업 복잡도, 가격, 속도, 신뢰성 사이의 실시간 trade-off라고 설명합니다. OpenRouter가 요청을 평가해 이 기준에 맞는 모델로 동적으로 보낸다는 설명도 덧붙였습니다.
라우터는 들어온 요청의 성격과 운영 조건에 따라 모델 선택을 바꿀 수 있게 합니다. OpenRouter는 이런 model-agnostic routing과 함께 관찰 기능과 비용 관리를 제공한다고 밝히고 있습니다.
멀티모델 환경에서 선택은 구매 결정 한 번이 아니라, 요청이 들어올 때마다 반복되는 운영 결정이 됩니다.
모델을 고른 뒤에도 provider를 다시 골라야 합니다
같은 모델이 여러 provider에서 제공되면 두 번째 선택이 생깁니다. 어느 provider로 요청을 보낼지 정해야 합니다.
OpenRouter의 공식 문서에 따르면 기본 설정은 상위 공급자(provider) 사이에서 요청을 분산해 가동률(uptime)을 높입니다. 사용자는 provider 순서를 직접 지정하거나 가격·처리량(throughput)·지연시간(latency) 기준으로 우선순위를 조정할 수 있습니다. 첫 provider를 쓸 수 없을 때 backup provider를 허용하는 fallback도 기본값입니다.
fallback은 첫 provider를 사용할 수 없을 때 backup provider를 시도하도록 설계돼 있습니다. 특정 provider 사용 여부가 중요하다면 사용자가 허용 범위와 우선순위를 좁힐 수 있습니다. 운영 조건을 한곳에서 표현하고 반복 적용하는 구조입니다.
대화를 이어갈 때는 무조건 다른 곳으로 보내면 안 됩니다
가격이나 가용성만 보고 매 요청을 다른 provider로 보내면 또 다른 문제가 생깁니다. 앞선 요청에서 만들어 둔 prompt cache가 특정 provider endpoint에 남아 있기 때문입니다.
OpenRouter는 캐시 적중(cache hit)을 높이기 위해 후속 요청을 같은 provider endpoint로 보내는 sticky routing을 사용합니다. 같은 대화가 이어지는 동안 cache를 유지하려는 방식입니다. 그 provider를 사용할 수 없게 되면 다음 provider로 자동 fallback합니다.
라우팅은 당장의 요청 가격, 응답 속도, 장애 가능성에 더해 다음 요청에서 cache를 다시 쓸 수 있는지도 함께 고려합니다.
Stripe가 이 층을 고른 이유는 어디까지 확인됐나
Stripe는 이번 발표에서 AI 요청을 어떤 모델에 어떤 속도와 가격으로 보낼지 실시간으로 결정하는 문제라고 설명했습니다.
여기서부터는 공식 발표를 바탕으로 한 해석입니다. AI에서도 token 요청을 어느 모델과 provider로 보낼지 정하는 층에 경제적 가치가 생겼다고 볼 수 있습니다. 모델 사용량이 늘수록 이 층은 비용과 안정성을 함께 관리하는 위치에 놓입니다.
다만 이번 거래가 멀티모델 구조의 승리를 확정하거나 단일 모델 중심 서비스가 사라진다는 뜻은 아닙니다. 공식 발표에 거래 금액도 나오지 않았습니다. 확인된 것은 Stripe가 OpenRouter 인수에 합의했고, 그 이유를 token routing과 사용 최적화에 연결했다는 사실입니다.
인수 뒤에도 중립적인 라우터로 남을까
여러 모델 사이의 중간층은 선택을 맡는 만큼 중립성이 중요합니다. OpenRouter는 인수 발표 뒤에도 같은 제품·미션·현재 약속을 유지하며, 사용자를 위한 선택을 기준으로 라우팅하겠다고 밝혔습니다.
현재는 회사의 공식 약속입니다. 거래가 끝난 뒤 provider 노출, 가격, 기본 routing과 제품 roadmap이 실제로 어떻게 유지되는지는 이후 문서와 동작으로 다시 확인해야 합니다.
멀티모델 라우팅이 독립 인프라가 됐다는 뜻
OpenRouter의 역할을 네 단계로 줄이면 이렇습니다.
| 단계 | 라우터가 푸는 문제 |
|---|---|
| 모델 선택 | 작업 복잡도·가격·속도·신뢰성에 맞는 모델은 무엇인가 |
| provider 선택 | 같은 모델을 어느 공급자에게 보낼 것인가 |
| 연속성 | 실패하면 어디로 넘기고, 대화 cache는 어떻게 유지할 것인가 |
| 운영 | 사용량·비용·성능·가용성을 어떻게 관찰할 것인가 |
모델 수가 늘수록 이 네 문제는 모델 호출 코드 안에 흩어 두기 어려워집니다. 별도의 라우팅 층이 생기면 모델과 provider를 바꾸더라도 관찰, 비용 관리와 fallback 정책을 한곳에서 다룰 수 있습니다.
Stripe의 OpenRouter 인수 합의는 이 중간층이 편의 기능을 넘어 하나의 사업이자 인프라로 평가받고 있다는 신호입니다. 앞으로 볼 것은 거래 금액에 대한 추측보다, 인수 뒤에도 OpenRouter가 여러 모델 사이에서 사용자에게 유리한 선택을 유지하는지입니다.
핵심만 정리하면
- Stripe가 OpenRouter를 인수하려는 핵심 이유는 AI 요청을 작업 복잡도·가격·속도·신뢰성에 맞는 모델로 보내는 라우팅 역량에 있습니다. 거래는 아직 합의 단계입니다.
- 중요한 점은 OpenRouter가 단순한 API 연결을 넘어 모델 선택, provider fallback, cache, 관찰과 비용 관리를 한곳에서 맡는다는 것입니다.
- AI 서비스가 여러 모델을 함께 쓸수록 어떤 모델과 provider를 언제 사용할지 정하는 이 중간층의 역할도 커집니다.