같은 AI 모델인데 성능이 다른 이유 — AI 하네스가 결과를 바꾸는 방식
같은 모델을 연결했는데도 한 도구는 긴 작업을 안정적으로 이어가고, 다른 도구는 앞선 판단을 충분히 이어가지 못할 수 있습니다. 화면 구성만 다른 것처럼 보여도 실제 차이는 더 깊은 곳에 있습니다.
AI 모델은 어떤 정보를 계속 들고 갈지, 무슨 도구를 쓸지, 실패하면 어떻게 처리할지 정하는 실행 시스템 안에서 움직입니다. 이 시스템을 AI 하네스(AI harness)라고 부릅니다.
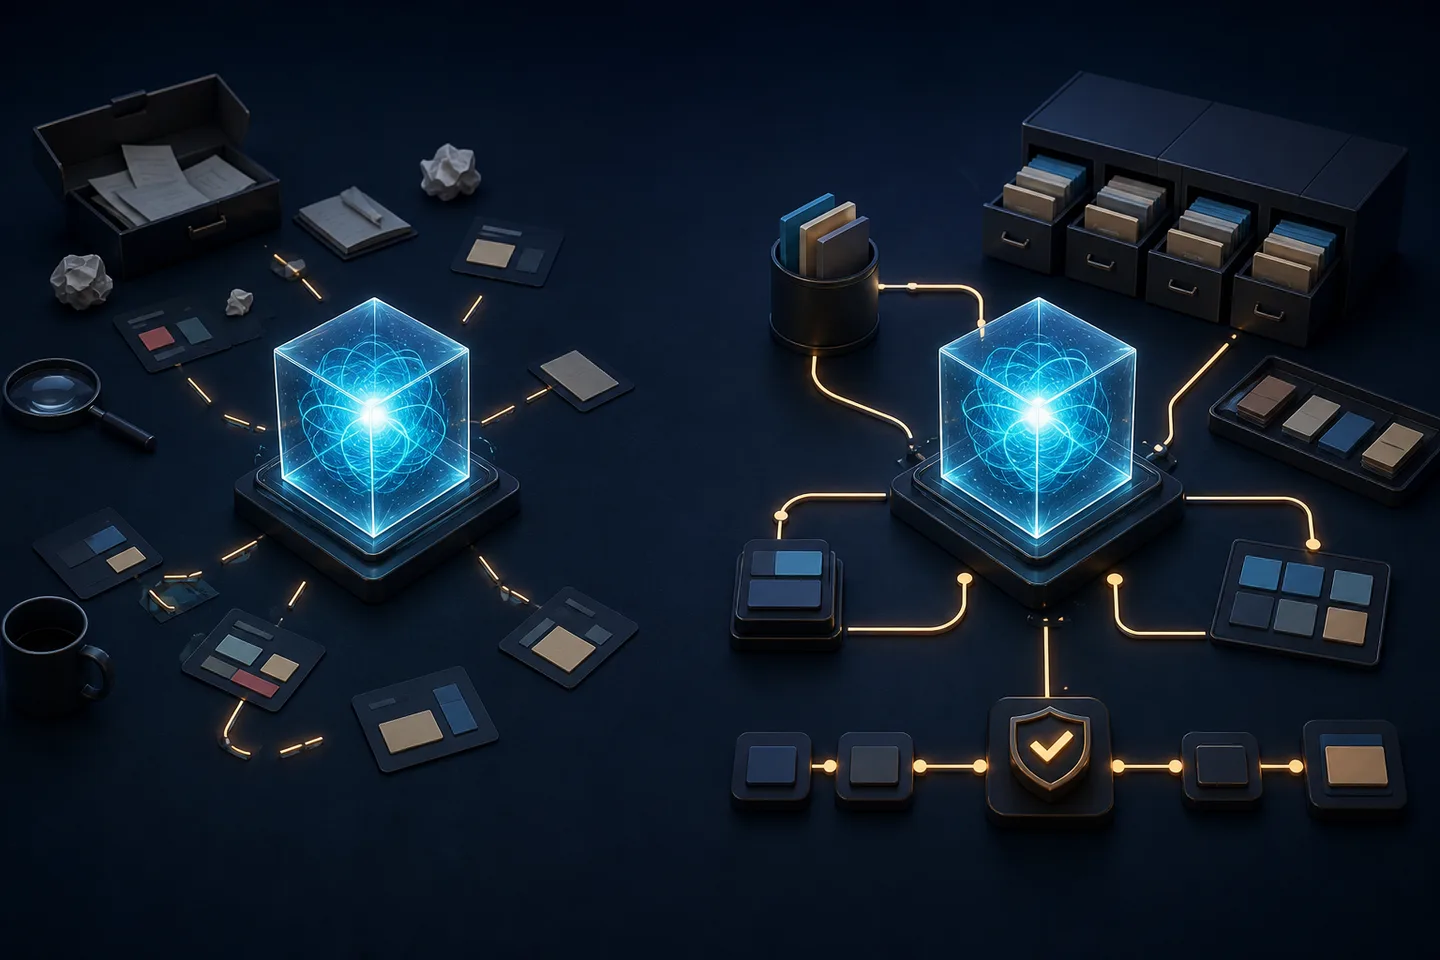
같은 모델이라도 주변의 기억·도구·승인 환경이 다르면 실제 작업 방식이 달라질 수 있습니다.
벤치마크도 모델만 측정하지 않습니다
OpenAI의 ARC-AGI-3 실험은 하네스가 결과에 미치는 영향을 한 숫자로 보여줍니다. 같은 GPT-5.6 Sol을 같은 공개 과제 세트에서 실행했지만 하네스 설정에 따라 결과가 달라졌습니다.
| 실행 조건 | ARC-AGI-3 공개 세트 점수 | 출력 토큰 |
|---|---|---|
| 공식 하네스 | 13.3% | 기준 |
| retained reasoning + compaction | 38.3% | 약 6분의 1 |
바뀐 것은 모델 가중치가 아니었습니다. OpenAI는 기존 하네스가 매 행동 뒤 private reasoning을 버리고, rolling truncation으로 오래된 행동을 잃었다고 설명합니다. 모델은 앞에서 세운 전략을 다음 행동에 충분히 이어 쓰기 어려웠습니다.
두 번째 조건에서는 이전 추론을 유지하는 retained reasoning과 오래된 맥락을 짧게 정리해 남기는 compaction을 켰습니다. 그러자 장기 전략 유지가 나아졌고 공개 세트 점수가 13.3%에서 38.3%로 올랐습니다.
이 결과는 “벤치마크 점수 = 모델 자체의 능력”이라는 등식이 충분하지 않다는 사례입니다. API 설정, 프롬프트와 하네스 설계도 함께 측정됩니다.
범위는 분명합니다. 특정 벤치마크에서 OpenAI가 자사 모델로 수행한 실험입니다. 이 수치만으로 일반적인 글쓰기·코딩·검색 성능을 예측하거나, ChatGPT·Codex·Cursor 가운데 한 제품이 항상 낫다고 결론 낼 수는 없습니다.
하네스는 모델과 실제 작업 사이를 잇습니다
OpenAI는 capable agent에 필요한 실행 기능을 다음처럼 설명합니다. 작업을 이해하고, 오랫동안 컨텍스트를 유지하고, 관련 정보를 확인하고, 도구를 호출합니다. 진행 상태를 보여주고 실패를 처리하며, 필요한 행동 앞에서 사람의 승인을 요청한 뒤 결과를 반환합니다.
프롬프트 하나와 모델 응답 하나만으로는 이 흐름을 만들기 어렵습니다. 긴 작업에서는 상태가 계속 바뀌고, 도구 호출이 실패하며, 어떤 행동은 권한 확인이 필요합니다. 모델의 답을 실제 작업으로 바꾸려면 이 변화를 관리하는 반복 구조가 있어야 합니다.
Codex의 오픈소스 하네스는 App·CLI·IDE Extension의 기반입니다. 대화 상태와 실행 스트리밍, 도구 사용, sandbox와 approval policy, 여러 차례 이어지는 작업을 관리합니다. 모델이 무엇을 말할 수 있는지뿐 아니라 어디까지 행동할 수 있는지도 이 층에서 정해집니다.
같은 모델을 연결해도 결과가 달라지는 다섯 지점
하네스의 차이를 제품 UI보다 아래로 내려가 보면 비교 기준이 선명해집니다.
1. 이전 판단을 얼마나 오래 보존하는가
긴 작업에서 초반의 목표와 제약을 잃으면 뒤의 선택도 흔들립니다. retained reasoning과 compaction 사례에서는 컨텍스트 창의 크기보다 남길 정보와 줄일 정보를 다루는 방식이 결과를 바꿨습니다.
2. 어떤 정보와 도구를 연결하는가
같은 모델도 코드 저장소, 문서, 검색, 터미널 가운데 무엇을 볼 수 있는지에 따라 할 수 있는 일이 달라집니다. 하네스는 도구 목록과 함께 호출 순서, 실행 결과를 다음 판단에 넣는 과정까지 관리합니다.
3. 실패 뒤에 무엇을 하는가
하네스는 도구 호출 실패를 처리하고 그 상태를 사용자에게 보여주는 역할을 맡습니다. 처리 방식에 따라 작업을 이어갈 수 있는 범위와 사용자가 개입하는 시점도 달라집니다.
4. 권한과 승인 경계를 어디에 두는가
파일을 읽는 일과 삭제하는 일은 같은 권한으로 다루기 어렵습니다. sandbox는 실행 범위를 제한하고 approval policy는 사람 확인이 필요한 행동을 구분합니다. 하네스는 이 경계를 실제 도구 실행에 적용합니다.
5. 여러 차례의 작업 상태를 어떻게 이어가는가
한 번의 답변이 아니라 여러 turn에 걸친 작업에서는 현재 단계, 이미 시도한 방법, 남은 일을 기록해야 합니다. 이 상태가 끊기면 모델은 앞선 실패를 반복하거나 끝난 일을 다시 시작합니다.
모델 회사 밖에서도 실행층을 제품으로 만들고 있습니다
비슷한 움직임은 다른 제품에서도 나타납니다.
Cursor가 공개한 Origin Code Hosting의 early beta는 저장소, pull request, 코드 탐색과 GitHub 동기화를 한 공간에 둡니다. Agent는 그 공간에서 코드에 답하고 변경을 만들며 branch를 push하거나 pull request를 갱신할 수 있습니다. 코드와 작업 상태를 agent 가까이에 놓는 방식입니다.
DeepSeek Harness는 다른 접근을 택했습니다. 모델 adapter, tool registry, session log, agent loop 같은 구성 요소를 plugin 방식으로 교체할 수 있는 오픈소스 하네스입니다. 현재는 호환성이 깨지는 변경 가능성을 명시한 developer preview입니다.
두 제품의 기능과 완성도는 서로 다릅니다. 다만 저장소·도구·세션·정책을 관리하는 실행층을 모델과 별도로 설계하고 비교한다는 공통점이 있습니다.
AI 도구를 비교할 때 모델명 다음에 볼 것
모델 순위표는 출발점일 수 있지만 실제 작업 도구를 고르기에는 정보가 부족합니다. 다음 질문을 함께 보면 결과 차이를 더 구체적으로 이해할 수 있습니다.
- 작업에 필요한 컨텍스트와 도구가 연결돼 있는가
- 긴 작업에서 이전 판단과 실패 기록이 이어지는가
- 오류가 났을 때 복구 과정과 진행 상태를 볼 수 있는가
- sandbox와 사람 승인으로 행동 범위가 구분되는가
- 결과가 원래 업무 시스템이나 기록으로 돌아가는가
같은 모델이 서로 다른 제품에서 다르게 느껴지는 것은 이상한 일이 아닙니다. 실제 결과는 모델의 능력과 하네스의 실행 설계가 만나는 지점에서 나옵니다. 모델 이름이 같다는 사실보다, 그 모델이 어떤 기억과 도구와 권한을 가지고 일했는지가 더 직접적인 설명이 될 때가 있습니다.
핵심만 정리하면
- AI 하네스는 모델이 컨텍스트를 이어가고 도구를 쓰며, 실패·승인·작업 상태를 처리하도록 만든 실행 시스템입니다.
- 같은 GPT-5.6 Sol도 ARC-AGI-3 공개 세트에서 하네스 설정에 따라 13.3%와 38.3%라는 다른 결과를 냈습니다. 이 수치는 특정 벤치마크의 OpenAI 자사 실험으로 한정해서 봐야 합니다.
- AI를 비교할 때는 모델명과 함께 어떤 하네스 환경을 사용하는지도 봐야 합니다. 기억·도구·권한의 차이가 실제 결과에 영향을 줄 수 있습니다.